DeltaNet Notes
Published:
论文记录《Parallelizing Linear Transformers with the Delta Rule over Sequence Length》
模型
线性注意力移除了softmax,并可以表述成矩阵值状态的线性RNN,其中 \(S\) 积累了关键 \(k\) 的外积:
\[\mathbf{S}_t=\mathbf{S}_{t-1}+\mathbf{v}_t\mathbf{k}_t^\top\in\mathbb{R}^{d\times d},\quad\mathbf{o}_t=\mathbf{S}_t\mathbf{q}_t\in\mathbb{R}^d\]相较于Transformer,时间复杂度从 \(\mathcal{O}(L^2d)\) 变为 \(\mathcal{O}(Ld^2)\),空间复杂度从 \(\mathcal{O}(Ld^2)\) 变为 \(\mathcal{O}(d^2)\)。
这有着更加深刻的本质。TTT(Test Time Training)将序列模型的构建视为一个Online Learning问题,并提出用优化器来构建RNN。具体来说,参数 \(S_t\) 被看作数据信息压缩和记忆的一种形式,并将 \(K, V\) 看作预料对,训练 \(v=f(S_t;k)\),输出 \(o_t=f(S_t;q_t)\),而 SGD 则作为更新这些记忆的手段。进而,公式可以写成:
\[{o_t=f(S_t;q_t),\quad S_t=S_{t-1}-\eta_t\nabla_{S_{t-1}}\mathcal{L}(f(S_{t-1};k_t),v_t)}\]其中 \(\mathcal{L}(\boldsymbol{f}(\boldsymbol{S}_{t-1},\boldsymbol{k}_t),\boldsymbol{v}_t)\) 是当前数据 \((\boldsymbol{k}_t,\boldsymbol{v}_t)\) 在当前参数 \(\boldsymbol{S}_{t-1}\) 下的损失函数,\(\boldsymbol{\eta}_t\) 则是学习率参数. 此公式概述了一系列 linear attention model,包括 mamba,RWKV,DeltaNet等。
这种架构的缺点很明显:线性注意力中的固定大小状态矩阵(d*d)意味着无法完美保存所有历史信息。当我们尝试去检索特定键的值时:
\[\begin{aligned} \mathbf{Sk}_j =\sum\mathbf{v}_i(\mathbf{k}_i^\top\mathbf{k}_j) =\mathbf{v}_j+\underbrace{\sum_{i\neq j}(\mathbf{k}_i^\top\mathbf{k}_j)\mathbf{v}_i}_{\text{retrieval error}} \end{aligned}\]需要最小化error,即所有的 \(\mathbf{k}_i^\top\mathbf{k}_j=0\),但在模型 \(d\) 维空间中,只能有 \(d\) 个正交向量,一旦 \(L>d\) 就会出现问题。在这种键值关联记忆系统中,我们只能添加新的键值关联,无法擦除现有信息。随着序列变长,这会导致错误的积累,从而降低性能。
正如 David Eagleman 所说:
“The enemy of memory is not time; it’s other memories.”
由此,DeltaNet 希望擦除部分的记忆,设计为:
\[{o_t=S_tq_t,\quad S_t=S_{t-1}-\eta_t(S_{t-1}k_t-v_t)k_t^\top}\]后面的一部分等价于 \(\nabla_{\boldsymbol{S}_{t-1}}\frac{1}{2}\|\boldsymbol{S}_{t-1}\boldsymbol{k}_t{-}\boldsymbol{v}_t\|^2\),即将TTT形式的 \(f\) 设计成平方损失 \(\frac{1}{2}\|\boldsymbol{Sk}-\boldsymbol{v}\|^2\)。
并行化的尝试
整理成矩阵形式:
\[\begin{aligned} \mathrm{St} & =\mathbf{S}_{t-1}-\beta_t(\mathbf{S}_{t-1}\mathbf{k}_t-\mathbf{v}_t)\mathbf{k}_t^\top \\ & =\mathbf{S}_{t-1}-\beta_t\mathbf{S}_{t-1}\mathbf{k}_t\mathbf{k}_t^\top+\beta_t\mathbf{v}_t\mathbf{k}_t^\top \\ & =\mathbf{S}_{t-1}(\mathbf{I}-\beta_t\mathbf{k}_t\mathbf{k}_t^\intercal)+\beta_t\mathbf{v}_t\mathbf{k}_t^\top=\mathbf{S}_{t-1}\mathbf{M}_t+\mathbf{X}_t\in\mathbb{R}^{d\times d} \end{aligned}\]直观地,可以用 Parallel Scan 去完成并行训推:
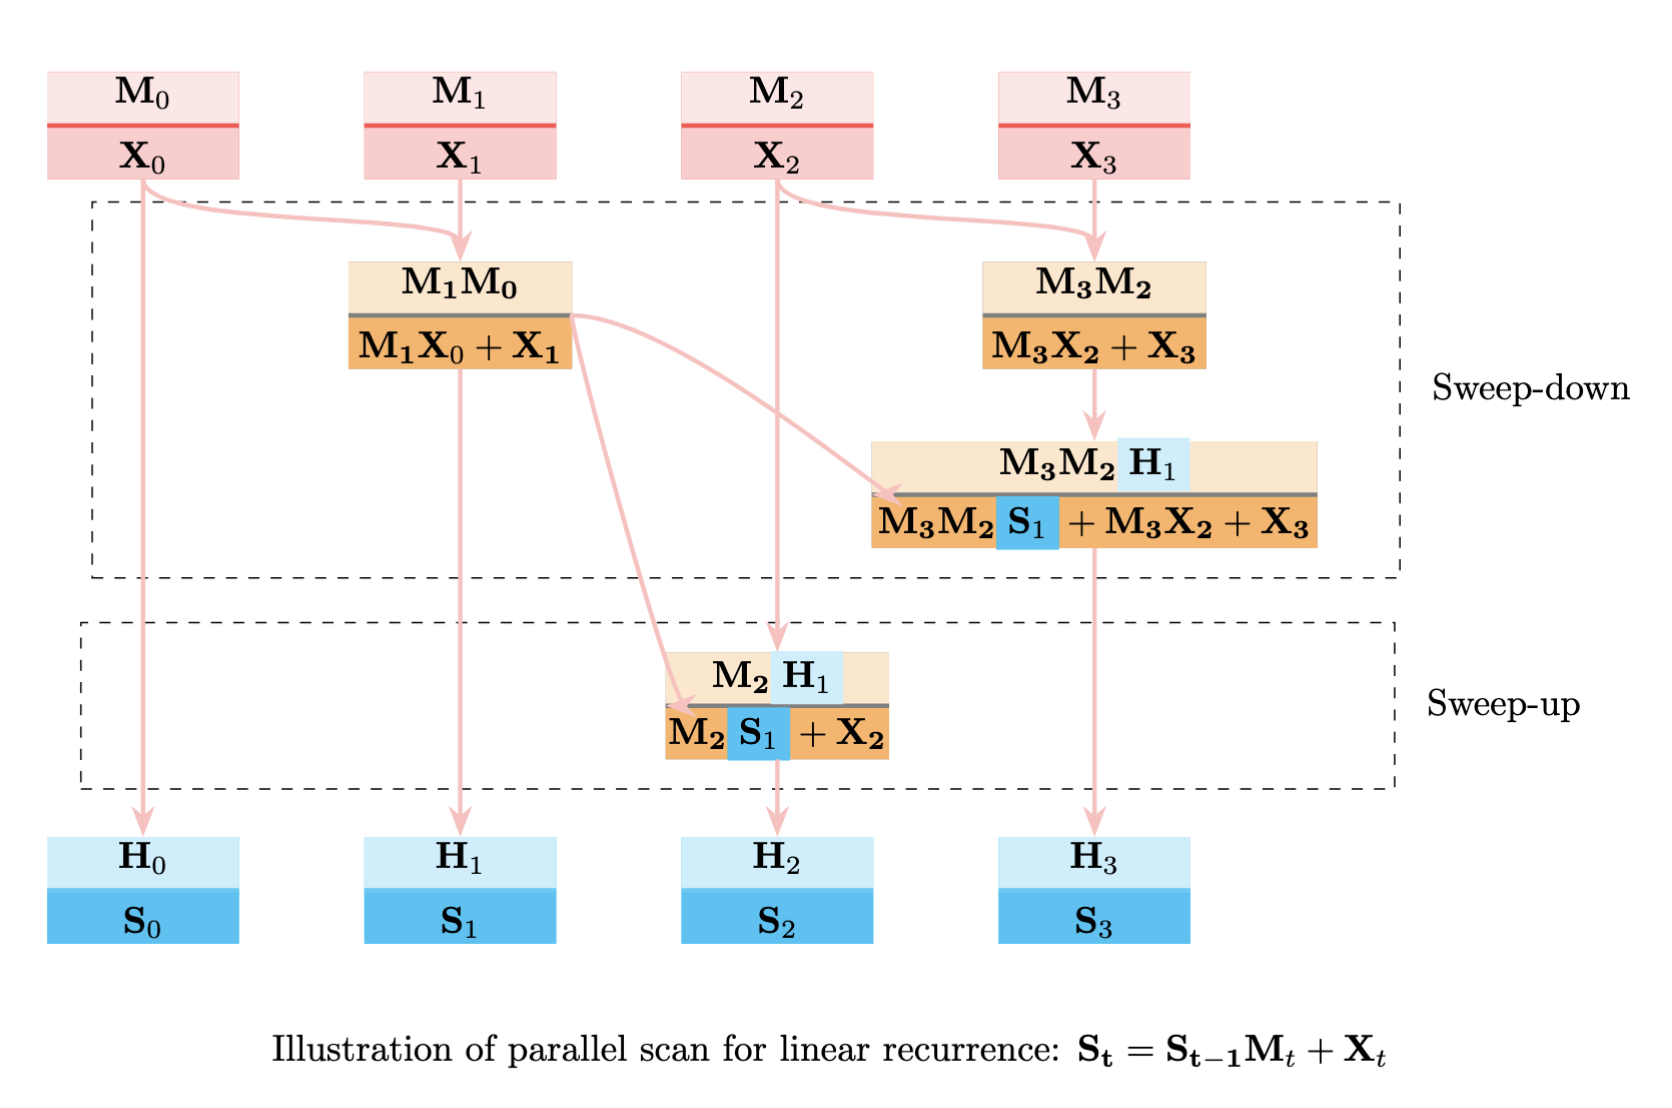
问题是:1)并行扫描需要在每一步将所有中间的d×d矩阵实现到 HBM 中,对于具有矩阵值态的线性 RNNs 内存需求是 \(\mathcal{O}(Ld^{2})\);2)注意图中的计算复杂度,将所有伴随矩阵的结果合并计算时,第一个括号中的每个项必须与第二个括号中的每个项相乘。这种乘法会导致项数呈二次增长。之后 \(\log L\) 平行扫描的层级,最终得到 \(O(L^{\log c})\) 项,其中 \(c\) 是每个矩阵的初始项数。尽管每个项都是第一秩,但项数呈指数增长。
如何解决内存问题?
线性注意力的高效在于它能够通过向量而非完整矩阵来保持状态的紧凑表示:
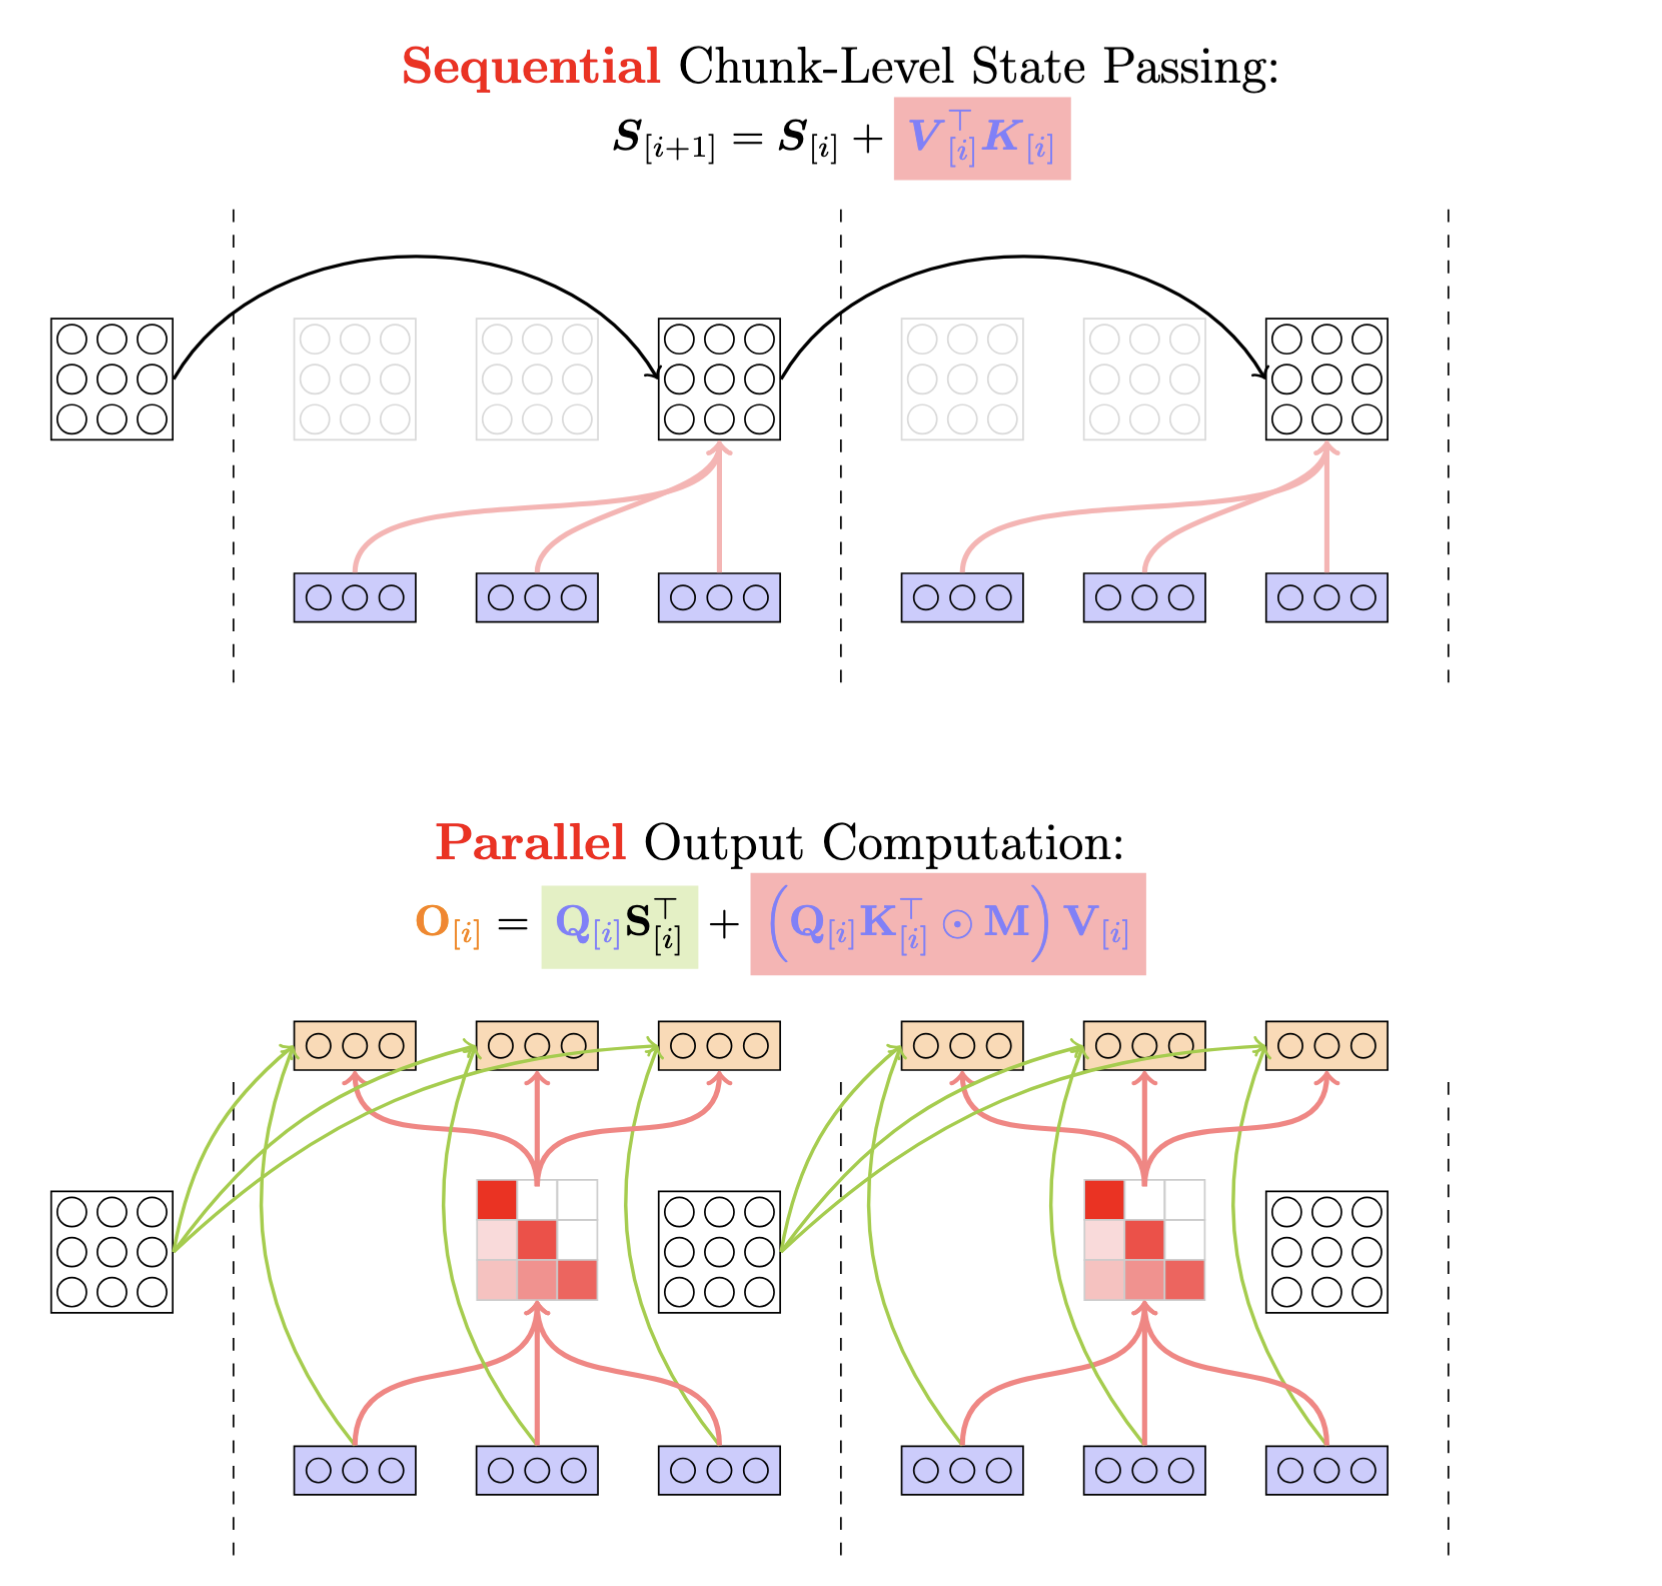
\[\sum_{i=1}^{t} \mathbf{v}_i \mathbf{k}_i^\top = \mathbf{V}_t \mathbf{K}_t^\top\]因此,我们无需存储所有中间隐藏状态,只需在大小的固定间隔内存存储状态$\mathbf{C}$作为存储的站点。
这分割出状态 \(\mathbf{S}_0, \mathbf{S}_C, \mathbf{S}_{2C}, \dots, \mathbf{S}_{(n-1)C}\)。对于块 \(i\) 内任意位置 \(r\),我们可以计算:
\[\mathbf{S}^r_{[i]} = \mathbf{S}_{[i]} + \sum_{t=1}^{r} \mathbf{v}^t_{[i]} \mathbf{k}^{t\top}_{[i]} \\ \mathbf{o}^r_{[i]} = \mathbf{S}^r_{[i]} \mathbf{q}^r_{[i]} = \mathbf{S}_{[i]} \mathbf{q}^r_{[i]} + \sum_{t=1}^{r} \mathbf{v}^t_{[i]} (\mathbf{k}^{t\top}_{[i]} \mathbf{q}^r_{[i]})\]在矩阵形式中,
\[\mathbf{S}_{[t+1]} = \mathbf{S}_{[t]} + \mathbf{V}_{[t]}^\top \mathbf{K}_{[t]} \quad \in \mathbb{R}^{d \times d}\] \[\mathbf{O}_{[t]} = \mathbf{Q}_{[t]} \mathbf{S}_{[t]}^\top + (\mathbf{Q}_{[t]} \mathbf{K}_{[t]}^\top \odot \mathbf{M}) \mathbf{V}_{[t]} \quad \in \mathbb{R}^{C \times d}\]简单来说,用块的方式做临时存储。
如何解决连乘矩阵的复杂度?
设 \(w\) 为单位向量,即 \(w^T w = 1\),则 Householder 变换矩阵为 \(H = I - 2 w w^T\)。 DeltaNet的过渡矩阵与 Householder matrices 非常相似(当 \(\beta=2\)),并且存在一个优雅的表示来表示它们的累积,这被称为 WY representation.
\[\prod_{i=1}^t(\mathbf{I}-\beta_i\mathbf{k}_i\mathbf{k}_i^\top)=\mathbf{I}-\sum_{i=1}^t\mathbf{w}_i\mathbf{k}_i^\top,\mathbf{S}_n=\sum_{t=1}^n\mathbf{u}_t\mathbf{k}_t^\top\]因此,展开 DeltaNet:
\[\begin{aligned} \mathrm{St} & =\mathbf{S}_{t-1}(\mathbf{I}-\beta_t\mathbf{k}_t\mathbf{k}_t^\top)+\beta_t\mathbf{v}_t\mathbf{k}_t^\top \\ & =\sum_{i=1}^t\beta_i(\mathbf{v}_i\mathbf{k}_i^\top)\left(\prod_{j=\boldsymbol{i}+1}^t(\mathbf{I}-\beta_j\mathbf{k}_j\mathbf{k}_j^\top)\right) \end{aligned}\]利用在大小为 C 的规律间隔存储状态。对于块 i 内任意位置 r,
\[\begin{aligned} \mathbf{S}_{[i]}^{\boldsymbol{r}} & =\mathbf{S}_{[\boldsymbol{i}]}\underbrace{\prod_{t=1}^r(\mathbf{I}-\beta_{[\boldsymbol{i}]}^t\mathbf{k}_{[\boldsymbol{i}]}^t\mathbf{k}_{[\boldsymbol{i}]}^{t\top})}_{\text{chunk-local cumprod: P}[\boldsymbol{i}]}+\underbrace{\sum_{t=1}^r(\beta_{[\boldsymbol{i}]}^t\mathbf{v}_{[\boldsymbol{i}]}^t\mathbf{k}_{[\boldsymbol{i}]}^{t\top}\prod_{\boldsymbol{s}=\boldsymbol{t}+1}^r(\mathbf{I}-\beta_{[\boldsymbol{i}]}^s\mathbf{k}_{[\boldsymbol{i}]}^s\mathbf{k}_{[\boldsymbol{i}]}^{s\top}))}_{\text{chunk-local state or cumprodsum: }\mathbf{H}_{[\boldsymbol{i}]}^r} \\ & =\mathbf{S}_{[\boldsymbol{i}]}(\mathbf{I}-\sum_{t=1}^r\mathbf{w}_{[\boldsymbol{i}]}^t\mathbf{k}_{[\boldsymbol{i}]}^{t\top})+\sum_{t=1}^r\mathbf{u}_{[\boldsymbol{i}]}^t\mathbf{k}_{[\boldsymbol{i}]}^{t\top} \end{aligned}\]其中 \(\mathbf{w}^t_{[t]}\) 以及 \(\mathbf{u}^t_{[t]}\) 是通过 WY 表示计算的,但从每个块的第一个位置开始,而不是序列的起始位置,从而实现跨块的并行计算。
\[\mathbf{w}^r_{[t]} = \beta^r_{[t]}\left(\mathbf{k}^r_{[t]} - \sum_{i=1}^{r-1} \mathbf{w}^i_{[t]} (\mathbf{k}^i_{[t]})^\top \mathbf{k}^r_{[t]}\right)\] \[\mathbf{u}^r_{[t]} = \beta^r_{[t]}\left(\mathbf{v}^r_{[t]} - \sum_{i=1}^{r-1} \mathbf{u}^i_{[t]} (\mathbf{k}^i_{[t]})^\top \mathbf{k}^r_{[t]}\right)\]矩阵的形式是
\[\begin{aligned} \mathbf{S}_{[i+1]} & =\mathbf{S}_{[i]}(\mathbf{I}-\mathbf{W}_{[i]}^\top\mathbf{K}_{[i]})+\mathbf{U}_{[i]}^\top\mathbf{K}_{[i]} \\ & =\mathbf{S}_{[i]}+\left(\mathbf{U}_{[i]}-\mathbf{W}_{[i]}\mathbf{S}_{[i]}^\top\right)^\top\mathbf{K}_{[i]} & & \in\mathbb{R}^{d\times d} \\ \mathbf{O}_{[i]} & =\mathbf{Q}_{[i]}\mathbf{S}_{[i]}^\top+\left(\mathbf{Q}_{[i]}\mathbf{K}_{[i]}^\top\odot\mathbf{M}\right)\left(\mathbf{U}_{[i]}-\mathbf{W}_{[i]}\mathbf{S}_{[i]}^\top\right) & & \in\mathbb{R}^{C\times d} \end{aligned}\]读到此处,我深刻感觉到自己数学能力的浅薄。这是一个精妙的设计。
注意到以下两个变量的构造是递归的,计算仍然是RNN串行的:
\[\begin{gathered} \mathbf{w}_{[t]}^{r}=\beta_{[t]}^r\left(\mathbf{k}_{[t]}^r-\sum_{i=1}^{r-1}\mathbf{w}_{[t]}^i\left(\mathbf{k}_{[t]}^i\right)^\top\mathbf{k}_{[t]}^r\right) \\ \mathbf{u}_{[t]}^r=\beta_{[t]}^r\left(\mathbf{v}_{[t]}^r-\sum_{i=1}^{r-1}\mathbf{u}_{[t]}^i\left(\mathbf{k}_{[t]}^i\right)^\top\mathbf{k}_{[t]}^r\right) \end{gathered}\]我们希望用UT变化改写成一次性可并行的矩阵形式。把序列位置看成图的节点,递推里的依赖关系就是有向边。因为是因果(causal),第 \(r\) 只依赖更早的 \(i < r\),所以边只从早到晚(或按文中定义从 \(j \to i\)),总之只在下三角出现。边权重可以写成:
\[-\beta_{[t]}^{r} \left(\mathbf{k}_{[t]}^{i}\right)^{\top} \mathbf{k}_{[t]}^{r}\]用邻接矩阵 \(A\) 表示 \(A[i,j]\) 表示从节点 \(j \to i\) 的边权重。 因为只允许 \(i < r\) 的因果依赖,所以 \(A\) 在对角线及以上为 0,只在严格下三角可能非零,可以构造 \(A_{[t]}\) 为:
\[\mathbf{A}_{[t]} = \mathrm{tril}\left(-\mathrm{diag}\left(\boldsymbol{\beta}_{[t]}\right) \mathbf{K}_{[t]} \mathbf{K}_{[t]}^{\top}, -1\right)\]记:
\[\mathbf{T}_{[t]}=(\mathbf{I}-\mathbf{A}_{[t]})^{-1}\]则:
\[\mathbf{w}_{[t]}=\mathbf{T}_{[t]}\operatorname{diag}\left(\boldsymbol{\beta}_{[t]}\right)\mathbf{K}_{[t]},\quad\mathbf{U}_{[t]}=\mathbf{T}_{[t]}\operatorname{diag}\left(\boldsymbol{\beta}_{[t]}\right)\mathbf{v}_{[t]}\]其实,\(\mathbf{A}\) 的构造也可以从整理后的原方程得出:
\[\mathbf{w}^r+\sum_{i=1}^{r-1}\left(\beta^r\left(\mathbf{k}^i\right)^\top\mathbf{k}^r\right)\mathbf{w}^i=\beta^r\mathbf{k}^r\]Structure
DeltaNet设计的模型包含了以下的结构:
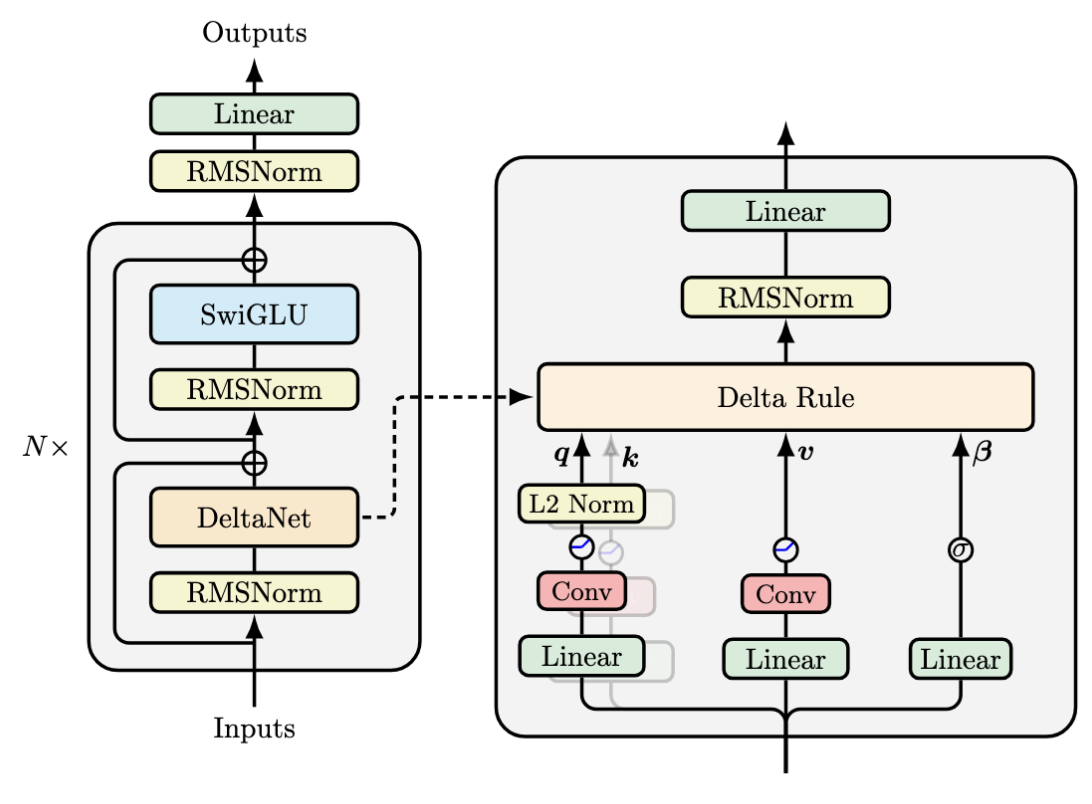
- Query/Key: Linear → ShortConv → SiLU → L₂Norm
- Value: Linear → ShortConv → SiLU
- Beta: Linear → Sigmoid
- Output: Delta rule(query, key, value, beta) → RMSNorm → Linear
Sonlin 在博客中提到,
\[\mathbf{S}_t = \mathbf{S}_{t-1}(\mathbf{I} - \beta_t \mathbf{k}_t \mathbf{k}_t^\top) + \mathbf{v}_t \mathbf{k}_t^\top\]其中,\(I-\beta kk^\top\) 在几何上表示:把任何向量在 \(k\) 方向的分量按系数 \((1-\beta\|k\|^2)\) 缩放;而在所有与 \(k\) 正交的方向完全不变。因此它的稳定性只取决于特征值:\(1-\beta\|k\|^2.\)(其他d-1个特征值都是1),因此可以得到约束:
\[-1\leq1-\eta_t\|\mathbf{k}_t\|^2\leq1\]此约束可以通过设置 \(\mathbf{k}\) 的 L2-norm 以及 \(\eta\) 的 sigmoid 得到。
对于Conv的设计,苏神在其博客中有提到:为了保持TTT在键值同源的情况提高性能,用 \(\mathbf{k}_{t-1}\) 预测 \(\mathbf{v}_t\) 之外,为了不浪费 \(\mathbf{k}_t\) 的信息,可以将两者用conv2的方式混合,将TTT的训练目标从预测自己转化为NTP,让TTT至少有能力学出一个n-gram模型。
在 Error-Free Linear Attention is a Free Lunch: Exact Solution from Continuous-Time Dynamicszhogn 中,作者将原来的公式连续化,得到:
\[{\frac{d}{dt}}\boldsymbol{S}_t=\boldsymbol{S}_t\underbrace{(-\boldsymbol{k}_t\boldsymbol{k}_t^\top)}_{\boldsymbol{A}_t}+\underbrace{\boldsymbol{v}_t\boldsymbol{k}_t^\top}_{\boldsymbol{B}_t}\]相当于解一个常系数的微分方程,解为:
\[{S_t=S_{t-1}\left(I-\frac{1-e^{-\eta_t\|k_t\|^2}}{\|k_t\|^2}k_tk_t^\top\right)+\frac{1-e^{-\eta_t\|k_t\|^2}}{\|k_t\|^2}v_tk_t^\top}\]其中 \(\mathbf{k}\) 的 L2-norm 就体现了。
可以看出,转移矩阵特征值自动在 (0,1] 内,求解微分方程天然有更好的稳定性。因为微分方程伴随着连续性约束,加上矩阵是一个半负定矩阵,它的解是稳定的。以微分方程为出发点,能自动规避一些异常行为。